Forrester führt ATAMYA im aktuellen Report „The Product Information Management Systems Landscape, Q3 2026“ als Notable Vendor im PIM-Markt. Die Nennung kommt zu einem Zeitpunkt, an dem der Bochumer Anbieter auffällig schnell nachlegt, vor allem bei der KI-Integration. Viele PIM-Anbieter sprechen über KI. Interessanter ist die Frage, wie schnell daraus Funktionen werden, die im Alltag tragen. ATAMYA hat im Tech Talk am 7. Oktober 2026 gezeigt, was im dritten Quartal in die ATAMYA Product Cloud eingeflossen ist: Kategoriebäume, eine neu gedachte Suche, schlankere Workflows, Webhooks und eine GraphQL-API, die zur offiziellen Schnittstelle werden soll. Auffällig ist, wie viele dieser Neuerungen ein gemeinsames Ziel haben: KI-Agenten und Automatisierung sollen mit Produktdaten arbeiten können, ohne Umwege über Referenzlisten, Exporte oder Polling.
Kurz zusammengefasst
- Forrester führt ATAMYA im Report „The Product Information Management Systems Landscape, Q3 2026“ als Notable Vendor. Der Report sieht PIM auf dem Weg zum zentralen System für Produktdaten, getrieben vor allem durch KI und KI-Agenten.
- ATAMYA hat im Quartalsrhythmus eine ganze Reihe von Funktionen ausgeliefert: Kategoriebäume, eine vereinheitlichte Suche, fünf neue Oberflächensprachen, eigene Datensprachen, Workflow-Optimierungen, Import und Export von Maßeinheiten sowie Webhooks.
- Für die KI-Integration besonders wichtig: Workflows geben Auswahlwerte jetzt als lesbaren Text statt als interne ID aus, und neue Service Tasks schreiben mehrere KI-Ergebnisse in einem Schritt ins Produkt.
- Startbedingungen sorgen dafür, dass Workflows nur noch dann laufen, wenn sie wirklich gebraucht werden, etwa wenn ein Lieferantenimport, ein ERP oder ein KI-Agent sicherheitsrelevante Attribute ändert.
- GraphQL soll bis Ende 2026 die offizielle öffentliche API werden. Schon jetzt ist sie per API-Key testbar. Die REST-API bleibt vorerst bestehen, wird aber nicht mehr erweitert.
Ein Anbieter mit Tempo
ATAMYA ist ein inhabergeführter Anbieter aus Bochum mit Wurzeln, die bis 1990 zurückreichen. Die ATAMYA Product Cloud ist cloud-nativ nach MACH-Prinzipien aufgebaut: Microservices, API-first, Cloud und Headless. Laut Hersteller wurde KI nicht nachträglich angebaut, sondern von Anfang an mitentwickelt. Einen Überblick über das Unternehmen und Referenzkunden finden Sie in unserem
Anbieterprofil zu ATAMYA.
Bemerkenswert ist vor allem die Taktung. ATAMYA stellt seinen Partnern im Quartalsrhythmus vor, was ausgeliefert wurde, und zeigt die Funktionen live im System. Im Herbst 2026 waren das sieben Themenblöcke in einem Quartal.
Forrester: ATAMYA als Notable Vendor im PIM-Landscape
Ende September 2026 hat ATAMYA bekanntgegeben, dass Forrester das Unternehmen im Report „The Product Information Management Systems Landscape, Q3 2026“ als Notable Vendor führt. Der Landscape-Report von Principal Analyst Tony Plec gibt einen Überblick über relevante Anbieter im PIM-Markt, ihre Größe sowie ihre regionalen und fachlichen Schwerpunkte. Er beschreibt außerdem Marktdynamik, Anwendungsfälle und die Richtung, in die sich der Markt bewegt. Eine Rangfolge der Anbieter enthält ein Landscape-Report nicht.
Für die Entwicklung von PIM-Systemen beschreibt Forrester eine klare Richtung. PIM ist nicht mehr nur ein Werkzeug für Marketing- und Commerce-Inhalte:
„Increasingly, they are becoming the system of record for managing and governing product data across the business, supporting operations, AI initiatives, and compliance efforts.“
The Product Information Management Systems Landscape, Q3 2026, Forrester Research, Inc., September 2026
Als stärksten Treiber der Veränderung nennt der Report KI, vor allem agentische KI, die das Produktdatenmanagement von manuellen Abläufen hin zu autonomer oder teilautonomer Ausführung verschiebt. Damit ändert sich auch, wer Produktdaten liest:
„This shift is also changing how product data is consumed as AI agents and emerging agentic commerce models require structured, machine-readable content.“
The Product Information Management Systems Landscape, Q3 2026, Forrester Research, Inc., September 2026
Genau an dieser Stelle setzen die Neuerungen an, die ATAMYA im dritten Quartal ausgeliefert hat: lesbare Werte für Agenten, KI-Ergebnisse, die direkt und kontrolliert ins Produkt fließen, und Schnittstellen, über die Systeme und Agenten gezielt auf strukturierte Daten zugreifen. Der Report steht bei ATAMYA
zum kostenlosen Download bereit.
Forrester does not endorse any company, product, brand, or service included in its research publications and does not advise any person to select the products or services of any company or brand based on the ratings included in such publications. Information is based on the best available resources. Opinions reflect judgment at the time and are subject to change. For more information, read about Forrester’s objectivity.
Was im dritten Quartal 2026 ausgeliefert wurde
| Neuerung |
Was sie leistet |
Nutzen für KI und Automatisierung |
| Kategoriebäume |
Beliebig viele hierarchische Kategoriebäume neben den Domänen, z. B. für B2B-Portfolio, Webshop oder Warengruppen. Ein Produkt kann mehreren Kategorien zugeordnet werden. |
Eindeutige, maschinenlesbare Einordnung als Kontext für Agenten und Kanäle |
| Neue Suche |
Suche direkt in der Domäne, Autovervollständigung für IDs und Systemfelder, Volltext und Kriterien in einer Suchleiste, Und/Oder-Verknüpfung, Filter auf leere Bildfelder |
Teilbare Suchabfragen, die sich auch zur Auswahl von Objekten für Ausleitungen nutzen lassen |
| Sprachen |
Fünf neue Oberflächensprachen (Französisch, Niederländisch, Portugiesisch, Italienisch, Spanisch) und eigene Datensprachen jenseits der ISO-Liste |
Sprachvarianten als saubere Datendimension, z. B. für KI-Übersetzungen |
| Display-Werte in Workflows |
Auswahlattribute liefern im Workflow-Ausdruck den gepflegten Wert statt nur die Options-ID, wählbar in jeder gepflegten Sprache |
Agenten arbeiten mit lesbaren Werten, ohne Referenzlisten im Prompt |
| Mehrere Merkmale in einem Schritt |
Neue Service Tasks bearbeiten ein oder mehrere Merkmale eines Geschäftsobjekts oder einer Gruppe, manuell oder per Ausdruck |
KI-Antworten fließen gesammelt ins Produkt, mit nur einer Speicherung |
| Startbedingungen |
Workflows prüfen vor dem Start Domäne, Objekt-ID und geänderte Attribute |
Weniger unnötige Workflow-Läufe, gezielte Governance für kritische Attribute |
| Maßeinheiten im Im- und Export |
Einheiten, Übersetzungen, Symbole und Umrechnungsfaktoren per Tabelle pflegen, mit Prüfbericht nach dem Import |
Konsistente Einheiten als Basis für Vergleiche und Berechnungen |
| Webhooks |
Ereignisse wie Anlage, Änderung, Aktivierung, Deaktivierung, Kopie oder Löschung an Zielsysteme melden, protokolliert im Log |
Ereignisgesteuerte Integration statt regelmäßiger Abfragen |
Dazu kamen Attribut-Voreinstellungen für die Print-Integration. Im Folgenden gehen wir auf die Neuerungen ein, die für die KI-Integration den größten Unterschied machen.
KI-Agenten bekommen lesbare Daten
Ein unscheinbares Detail mit großer Wirkung: Bisher gab die Expression Language in ATAMYA-Workflows bei Auswahlattributen nur die interne Options-ID aus. Ein KI-Agent bekam dann zum Beispiel „atr_s2_15“ statt „S2 – 15 min“ geliefert. Wer mit Agenten arbeitete, musste im Prompt eine Referenzliste mitgeben, die erklärt, was hinter den IDs steckt. Bei Daten aus Altsystemen, deren IDs wenig sprechend sind, war das fehleranfällig.
Mit dem neuen Ausdruck für den Display-Wert liefert der Workflow jetzt den tatsächlich gepflegten Wert, auf Wunsch in einer bestimmten Sprache. ID und Wert lassen sich kombiniert ausgeben: lesbar für Menschen und Sprachmodelle, eindeutig für Systeme. Das klingt nach einem kleinen Schritt, beseitigt aber eine typische Fehlerquelle in KI-Prompts und spart Kontext, den das Modell sonst für Übersetzungstabellen verbraucht.
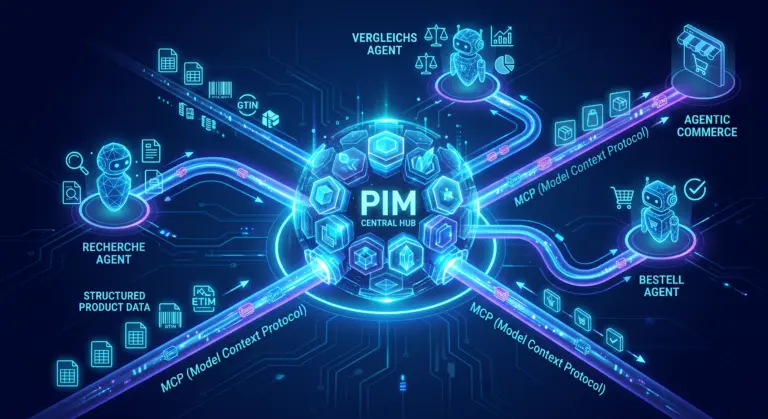
Genau diese Frage stellen wir auch in Projekten: Kann ein Agent Ihre Produktdaten verstehen, ohne dass jemand sie vorher übersetzt? Warum strukturierte, sprechende Attribute für KI-Agenten so entscheidend sind, haben wir in unserem Beitrag zu
MCP und Agentic Commerce beschrieben.
Verstehen KI-Agenten Ihre Produktdaten?
Das beste PIM nützt wenig, wenn Attribute, Klassifikation und Beziehungen für Maschinen nicht eindeutig sind. Unser Assessment zeigt, wo Ihr Datenmodell steht, unabhängig vom eingesetzten System.
Agentic Readiness prüfen
KI-Ergebnisse fließen in einem Schritt ins Produkt
In ATAMYA läuft KI nicht in einem separaten Chatfenster, sondern als Service Task in einer BPMN-Workflow-Engine. Der Hersteller bietet dafür vorgefertigte KI-Aufgaben, etwa zum Generieren und Übersetzen von Texten, zum Extrahieren von Attributen aus PDF-Datenblättern oder als Entscheidungshilfe, die nur „wahr“ oder „falsch“ zurückgibt und damit einen Workflow verzweigt. Das Sprachmodell wählt der Kunde selbst („Bring your own LLM“), etwa von OpenAI, Anthropic, Google, über Azure oder AWS Bedrock oder als privates Enterprise-Modell.
Bisher stieß dieses Prinzip an eine praktische Grenze: Liefert ein Agent Werte für mehrere Merkmale, musste jedes Merkmal in einem eigenen Service Task gespeichert werden. Die neuen Tasks „Merkmalswerte eines Geschäftsobjekts bzw. einer Geschäftsobjektgruppe bearbeiten“ lösen das. Ein Ausdruck nimmt die KI-Antwort als Liste auf, etwa Beschreibung, Barcode und Preis, und schreibt alle Werte in einem Schritt.
Der Effekt geht über Bequemlichkeit hinaus. Weil nur einmal gespeichert wird, laufen Kanal-Synchronisation, Prüfungen und Historie ebenfalls nur einmal. Das bedeutet weniger Ereignisse im System, schnellere Verarbeitung und eine übersichtlichere Änderungshistorie. Gerade wenn KI-Anreicherung über Tausende Artikel läuft, macht das einen spürbaren Unterschied.
Workflows, die nur laufen, wenn sie gebraucht werden
Bei Kunden, die intensiv mit Workflows arbeiten, können in großen Systemen mehrere tausend Workflow-Instanzen pro Tag entstehen. Bisher startete ein Workflow bei jedem passenden Ereignis und prüfte erst danach, ob er überhaupt zuständig ist. Das kostet Laufzeit und füllt die Historie.
Mit den neuen Startbedingungen entscheidet ATAMYA schon vor dem Start, ob ein Workflow läuft. Geprüft werden können die Domäne, bestimmte Objekt-IDs und die Frage, welche Attribute sich geändert haben. Laut Hersteller erzeugt ein Import mit 10.000 Objekten damit nur noch die Workflow-Läufe, die tatsächlich gebraucht werden. Statt eines großen Workflows mit vielen Verzweigungen lassen sich mehrere schlanke Workflows bauen. Als nächster Schritt sind Filter auf Objekttypen angekündigt.
Für die KI-Governance ist das besonders interessant. Ein Beispiel aus der Präsentation: Gefahrgutattribute brauchen eine Freigabe, egal ob die Änderung aus einem Lieferantenimport, dem ERP, von einem Menschen oder von einem KI-Agenten kommt. Mit Startbedingungen auf genau diese Attribute lässt sich ein Prüfprozess gezielt auslösen. Zusammen mit den Human-in-the-Loop-Schritten, die ATAMYA als festen Bestandteil von Workflows vorsieht, entsteht so eine kontrollierbare Automatisierung statt einer Blackbox.
Offene Schnittstellen: GraphQL und Webhooks
Agenten und Automatisierung brauchen nicht nur gute Daten, sondern auch einen effizienten Zugang zu ihnen. Hier hat ATAMYA zwei wichtige Entscheidungen getroffen.
GraphQL wird die öffentliche API
Die ATAMYA-Oberfläche arbeitet intern schon seit Langem mit GraphQL. Diese API wird derzeit überarbeitet und soll bis Ende 2026 die offizielle öffentliche Schnittstelle werden, mit Dokumentation. Alles, was intern zwischen den Services genutzt wird und für Kunden sichtbar ist, soll darüber erreichbar sein: Produkte, aber auch Domänen, Einheiten, Kontexte und Kanäle.
Der Vorteil gegenüber REST: Ein System fragt genau die Felder ab, die es braucht, und kann Produktdaten, Kategorien und Maßeinheiten in einem Aufruf kombinieren. Ein Shop braucht andere Felder als ein Printkatalog oder ein Analyse-Werkzeug, und eine API bedient alle. Für KI-Agenten, deren Kontextfenster begrenzt ist, ist das ein echter Vorteil, weil sie weniger überflüssige Daten verarbeiten müssen.
Schon jetzt lassen sich in der Oberfläche API-Keys für GraphQL erzeugen. Damit entfällt der bisherige Umweg über temporäre Tokens, und Werkzeuge wie Postman lassen sich direkt anbinden. ATAMYA weist darauf hin, dass sich Schema und Abfragen bis zur öffentlichen Freigabe noch ändern können. Die REST-API bleibt vorerst bestehen, neue Funktionen kommen aber nur noch in die GraphQL-API.
Webhooks: ATAMYA meldet sich, wenn sich etwas ändert
Bisher mussten Zielsysteme regelmäßig nachfragen, ob sich Produktdaten geändert haben. Mit Webhooks dreht ATAMYA das Prinzip um: Das PIM sendet ein Ereignis an eine Zieladresse, etwa an einen Shop, ein ERP oder eine Middleware, sobald ein Objekt angelegt, geändert, aktiviert, deaktiviert, kopiert oder gelöscht wird. Welche Ereignisse übertragen werden, ist frei wählbar und lässt sich auf Geschäftsobjekte oder Gruppen eingrenzen. Jede Übertragung wird protokolliert.
Ereignisgesteuerte Integration ist eine der Grundlagen agentischer Architekturen. Ein Agent, der Preise überwacht oder Marktplatzlistings aktualisiert, sollte reagieren, wenn sich Daten ändern, statt in festen Intervallen alles neu abzufragen.
Ist Ihre PIM-Landschaft bereit für Agenten?
APIs, Events und Workflows entscheiden, ob KI im Prozess oder daneben arbeitet. Im Agentic Readiness Assessment bewerten wir Datenmodell, Governance und Integrationsfähigkeit und leiten konkrete nächste Schritte ab.
Zum Agentic Readiness Assessment
Bessere Datenpflege als Basis für bessere KI
Nicht jede Neuerung trägt „KI“ im Namen. Viele zahlen trotzdem darauf ein, denn KI-Ergebnisse sind nur so gut wie die Daten, auf denen sie beruhen.
- Kategoriebäume: Objekte lassen sich gleichzeitig in mehreren Bäumen einsortieren, ohne Datenduplikate und ohne Synchronisationsaufwand. Ein Baum kann Objekte aus mehreren Domänen strukturieren. Laut ATAMYA sind die Kategorien mit Suche, Im- und Export und Shopware-Synchronisation nutzbar. Die Anlage eines Baums ist Administrationsaufgabe, die Pflege der Kategorien liegt bei den Fachanwendern.
- Neue Suche: Wer die Abfragesprache nicht auswendig kennt, findet trotzdem das Richtige. Die Suche schlägt Felder, Operatoren und Werte vor und stellt Kriterien als lesbare Elemente dar. Besonders praktisch für die Datenqualität: Bildmerkmale lassen sich nach „gefüllt“ und „nicht gefüllt“ filtern, sodass Produkte ohne Assets schnell auffallen.
- Eigene Datensprachen: Neben den ISO-Sprachen lassen sich eigene Sprachcodes anlegen, etwa für kundenspezifische Sprachvarianten. Oberflächensprache und Datensprache bleiben getrennt: Ein Team kann auf Französisch arbeiten, während die Produktdaten auf Japanisch gepflegt werden.
- Maßeinheiten per Tabelle: Einheiten, Übersetzungen, Basiseinheiten, Symbole und Umrechnungsfaktoren lassen sich wie das Datenmodell per Excel pflegen und importieren. Der Import liefert einen detaillierten Bericht über Fehler und erfolgreiche Zeilen.
Der MCP-Server und der Blick nach vorn
Für den Zugriff von außen bietet ATAMYA bereits einen MCP-Server an. Laut Hersteller lässt sich derselbe konfigurierte Agent damit auch in Werkzeugen wie Claude Code oder n8n nutzen, und Workflows können über den MCP-Server von außen gestartet werden. Ergänzt wird das durch den „Sidekick“, der Fragen zum Sortiment in natürlicher Sprache beantwortet und dabei Datenmodell, Domänen und Regeln des Kunden kennt.
Im Tech Talk hat ATAMYA außerdem einen ersten Blick auf eine überarbeitete Oberfläche gegeben, mit einer einklappbaren Navigation am linken Rand und mehr Platz für die Daten. Der Hersteller betont, dass es sich um eine Vorschau handelt. Für die kommenden Monate hat ATAMYA angekündigt, KI-Workflows und Automatisierung weiterhin als strategischen Schwerpunkt zu behandeln.
Unsere Einschätzung
Was uns an den Neuerungen überzeugt, ist weniger eine einzelne Funktion als die Richtung. ATAMYA arbeitet konsequent an den Stellen, an denen KI-Integration in der Praxis hakt: lesbare Werte statt IDs, gesammeltes Zurückschreiben statt vieler Einzelschritte, gezielte Auslöser statt Massenläufe, Ereignisse statt Polling, eine API, die genau die benötigten Daten liefert. Das sind keine Showcase-Funktionen für eine Messe, sondern Verbesserungen, die Projekte im Alltag schneller und stabiler machen.
Ebenso positiv sehen wir, dass KI bei ATAMYA im Workflow verankert ist, mit Berechtigungen, Guardrails, Audit-Trail und Human-in-the-Loop-Schritten. Genau diese deterministischen Leitplanken halten wir für Voraussetzung, wenn Agenten nicht nur lesen, sondern Produktdaten schreiben.
Zwei Punkte sollten Unternehmen im Blick behalten. Erstens die API-Umstellung: Wer heute Integrationen baut, sollte GraphQL einplanen, aber berücksichtigen, dass sich das Schema bis zur offiziellen Freigabe noch ändern kann. Bestehende REST-Integrationen laufen weiter, profitieren aber nicht mehr von neuen Funktionen. Zweitens gilt für jedes PIM: Die beste Plattform ersetzt kein sauberes Datenmodell. Kategoriebäume, Einheiten und Startbedingungen entfalten ihren Wert erst, wenn Attribute, Zuständigkeiten und Qualitätsregeln klar definiert sind.
Für Unternehmen, die ein PIM auswählen, gehört ATAMYA nach diesem Quartal aus unserer Sicht auf die Liste der Anbieter, die man sich für KI-gestützte Produktdatenprozesse genauer ansehen sollte. Wie wir Anbieter herstellerneutral vergleichen, beschreiben wir in unserer
PIM-Auswahl.
Vom Funktionsumfang zum messbaren Fortschritt
Neue Funktionen helfen nur, wenn Datenmodell und Prozesse mitziehen. Starten Sie mit einem kompakten Deep-Dive oder einem Workshop mit Ihrem Team und erhalten Sie eine priorisierte Roadmap.
Assessment anfragen
FAQ
Was ist die ATAMYA Product Cloud?
Die ATAMYA Product Cloud ist ein cloud-natives PIM-System der ATAMYA GmbH aus Bochum. Sie verwaltet Produktinformationen zentral und spielt sie an Online- und Offline-Kanäle aus. Die Architektur folgt MACH-Prinzipien, KI-Funktionen sind in die Workflow-Engine integriert.
Was bedeutet die Nennung als Notable Vendor bei Forrester?
Forrester führt im Landscape-Report „The Product Information Management Systems Landscape, Q3 2026“ die Anbieter auf, die das Analystenhaus im PIM-Markt für relevant hält, und beschreibt deren Größe und Schwerpunkte. Der Report bewertet die Anbieter nicht gegeneinander und ist nach Forresters eigenem Hinweis keine Kaufempfehlung.
Welche KI-Modelle lassen sich mit ATAMYA nutzen?
ATAMYA verfolgt einen „Bring your own LLM“-Ansatz. Laut Hersteller können Kunden den Anbieter frei wählen, etwa OpenAI, Anthropic oder Google, auch über Azure oder AWS Bedrock, und private Enterprise-Modelle einbinden. Ein Modellwechsel soll ohne Anpassung der Workflows möglich sein.
Was ändert sich mit der GraphQL-API für bestehende Integrationen?
Die REST-API bleibt vorerst bestehen, wird aber nicht mehr erweitert. Neue Funktionen kommen nur noch in die GraphQL-API, die bis Ende 2026 offiziell und dokumentiert verfügbar sein soll. Bis dahin können sich Schema und Abfragen noch ändern.
Wofür braucht man Webhooks im PIM?
Webhooks melden Änderungen sofort an andere Systeme, etwa an einen Shop, ein ERP oder eine Middleware. Zielsysteme müssen dann nicht mehr regelmäßig nachfragen. Das spart Last und sorgt dafür, dass Änderungen schneller in allen Kanälen ankommen.
Bietet ATAMYA einen MCP-Server?
Ja. Laut Hersteller lassen sich ATAMYA-Agenten über einen MCP-Server auch in externen Werkzeugen wie Claude Code oder n8n nutzen, und Workflows können darüber von außen gestartet werden.
Quellen
Haben Sie Fragen? Wir beraten Sie gerne.
Sie möchten wissen, ob ATAMYA zu Ihren Anforderungen passt oder wie Sie KI-Workflows in Ihrem PIM aufsetzen?
Sprechen Sie uns an.